
PC industrial para visión artificial con PoE
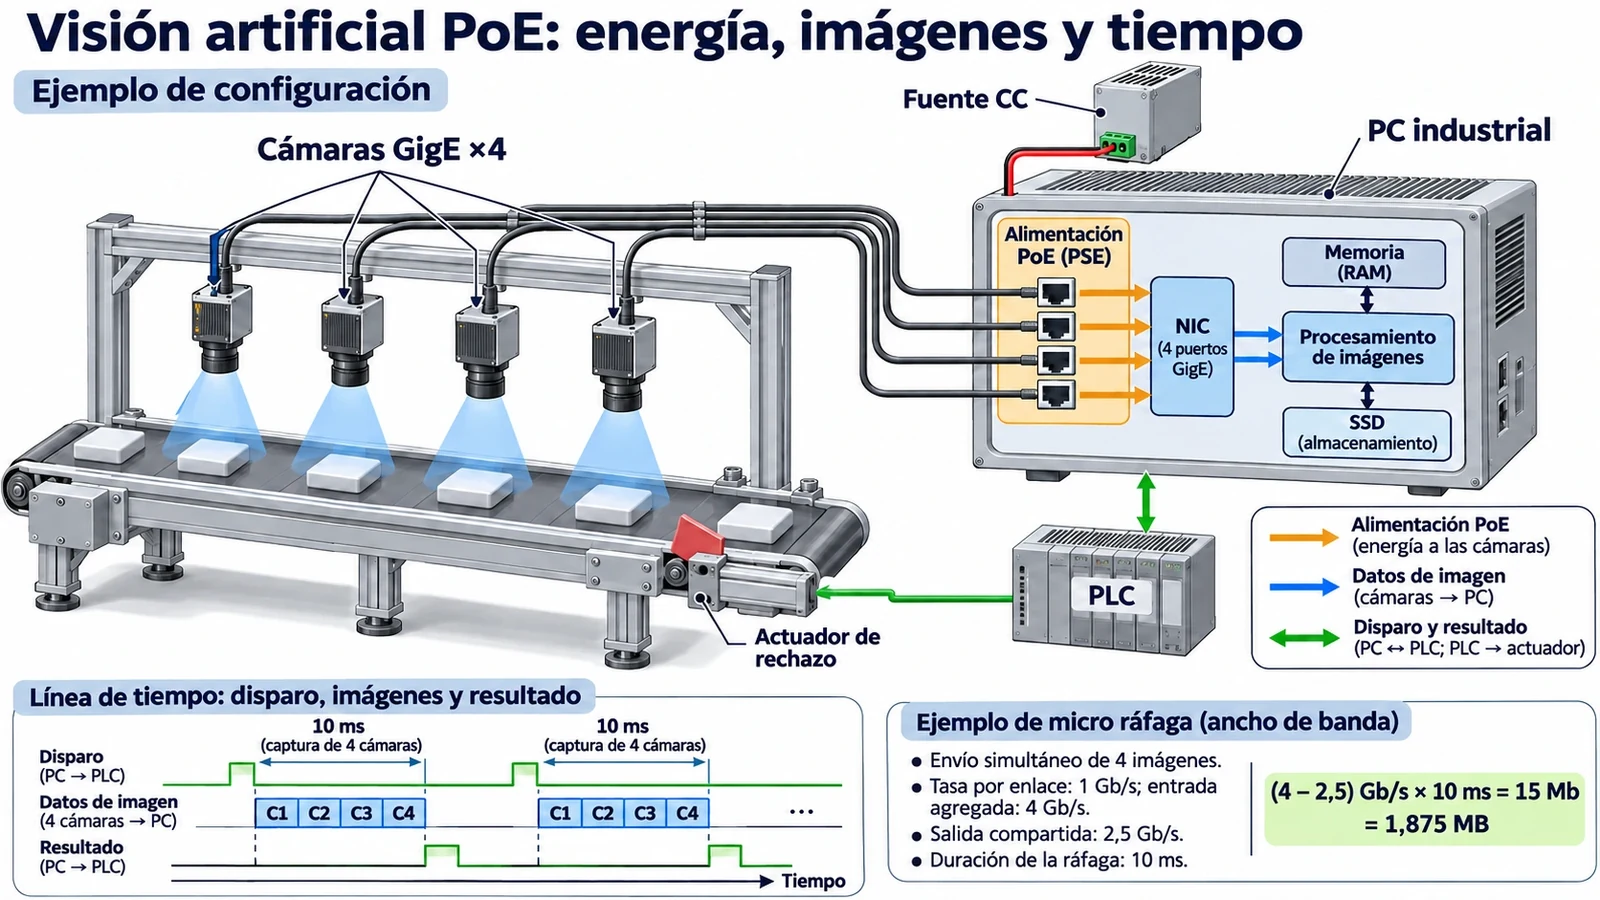
Cuatro puertos PoE parecen una respuesta sencilla para conectar cuatro cámaras. Durante la puesta en marcha, sin embargo, pueden aparecer fallos que no se explican contando conectores: una cámara se reinicia al arrancar un motor, las imágenes llegan incompletas cuando coinciden los disparos o la adquisición empieza a perder imágenes después de un tiempo guardando datos. Un procesador más rápido no resuelve necesariamente ninguno de estos problemas. Entre la fuente de alimentación y el resultado de inspección hay varios recursos compartidos, y cada uno tiene su propio límite.
Conviene seguir tres recorridos. La energía pasa de la fuente de corriente continua al PC, al equipo suministrador PoE —PSE— y, por el cable, a la cámara receptora —PD—. Las imágenes recorren el sensor, Ethernet, la tarjeta de red, PCIe, la memoria, el programa de adquisición y el procesamiento antes de llegar al almacenamiento. El tercer recorrido es temporal: detección de la pieza, disparo, exposición, cálculo, comunicación con el PLC y actuación del rechazo. Una imagen puede recuperarse sin errores y aun así resultar inútil si el veredicto llega después de que la pieza haya superado el punto de rechazo.
Los cálculos siguientes describen configuraciones hipotéticas, no mediciones de un producto concreto de Geshem. Las capacidades de una máquina dependen de su configuración, revisiones, firmware, controladores y montaje. Las ilustraciones explican relaciones funcionales; no representan un despiece real ni un informe de ensayo.
Empezar por una pieza y sus imágenes
La velocidad máxima de una cámara no define por sí sola el sistema. La región de interés, el formato de píxel, la exposición y el modo de disparo modifican tanto la imagen útil como el caudal. Antes de dimensionar el PC hay que relacionar la velocidad de la pieza y el defecto mínimo con el campo de visión, las vistas necesarias, los disparos por pieza, el plazo para devolver el resultado y los datos que deben conservarse. En una cámara lineal, el cálculo se hace con píxeles por línea, bytes por píxel y frecuencia de líneas a la máxima velocidad de producción; no basta con trasladar un valor de fps de una cámara matricial.
La iluminación pertenece a esta decisión. Si el movimiento durante la exposición supera el tamaño del defecto, un PC más potente no recuperará el detalle perdido. Alargar la exposición para compensar poca luz puede limitar la frecuencia de captura en el propio sensor. Por eso, el punto de partida es una combinación de parámetros que produzca una imagen válida para la inspección, no una lista de máximos de catálogo que quizá no puedan utilizarse a la vez.
El programa también debe identificar qué imágenes corresponden a cada pieza. En una inspección de cuatro vistas interesa vincular identificador de pieza y disparo, número de serie de la cámara, sesión de conexión, número de fotograma, tiempo, integridad y estado del resultado. Tras un reinicio, una cámara puede volver a numerar desde cero; sin separar sesiones, una imagen nueva podría completar por error un grupo antiguo. Un contador global de fps no revela duplicados, asociaciones incorrectas ni la primera pieza que entró antes de que la adquisición estuviera preparada.
Presupuesto PoE: puerto, equipo completo y arranque
Un PSE conforme con IEEE detecta un receptor válido y determina la clase o el mecanismo de asignación antes de alimentar. Una cámara que no enciende puede estar afectada por detección, clasificación, presupuesto agotado o protección; no demuestra por sí sola que la fuente esté averiada. Los dispositivos anunciados como «24 V Passive PoE» no equivalen al PoE IEEE. Tampoco un PC que recibe alimentación PoE es necesariamente capaz de suministrarla a cámaras: ser PD y ser PSE son funciones distintas.
| Tipo | Referencia en el PSE | Referencia disponible en el PD | Qué comprobar |
|---|---|---|---|
| Type 1 / 802.3af | 15,4 W | 12,95 W | Consumo en el modo máximo de la cámara |
| Type 2 / 802.3at, PoE+ | 30 W | 25,5 W | No confundir potencia de salida y potencia en el receptor |
| Type 3 / 802.3bt | Hasta 60 W | Hasta 51 W | Clase y alimentación por cuatro pares en los niveles superiores |
| Type 4 / 802.3bt | Hasta 90 W | Aproximadamente 71,3 W | Corriente, cable, conectores y temperatura |
La explicación de TI sobre PoE ayuda a interpretar estos valores, que no sustituyen la ficha del equipo. Cuatro puertos Type 2 no implican 120 W simultáneos. Si el presupuesto total del PSE es de 60 W, cuatro receptores de 20 W no caben aunque ningún puerto exceda su límite individual.
La potencia consumida y la reservada pueden diferir. Supongamos cuatro cámaras con entrada máxima de 12 W cada una: la carga suma 48 W. Si se identifican como Class 3 y el PSE reserva 15,4 W por clase, la asignación total será de 61,6 W. Un PSE de 60 W podría negar el encendido del último puerto aunque el consumo instantáneo medido sea inferior. Al proveedor le interesa conocer modelo y cantidad de cámaras para explicar la clase detectada, el reparto del presupuesto, las prioridades y el modo de recuperación tras una protección.
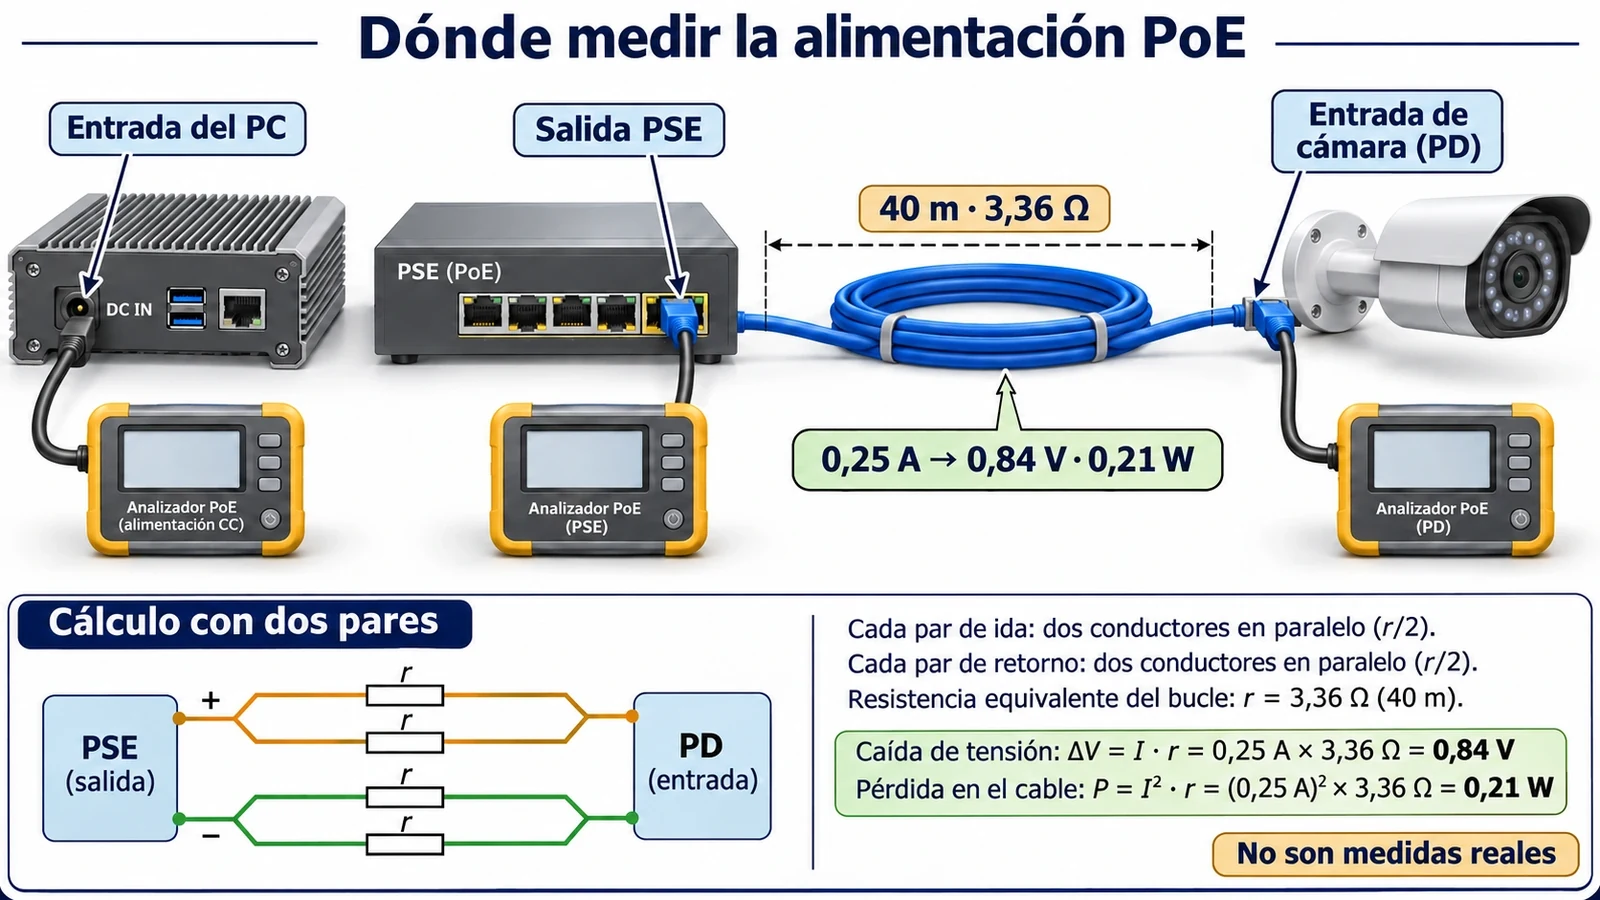
Las pérdidas del cable se calculan según el circuito de alimentación. En el caso ideal de dos pares, dos conductores en paralelo forman la ida y otros dos, el retorno. Si cada conductor tiene resistencia r, el bucle resulta r/2 + r/2 = r. Con 40 m y una resistencia supuesta de 0,084 Ω/m por conductor, r vale 3,36 Ω. A 0,25 A se obtienen ΔV = IR = 0,84 V y pérdidas I²R = 0,21 W, sin añadir conectores ni variaciones térmicas. La alimentación por cuatro pares requiere considerar cómo se reparte la corriente; no admite sustituir sin más la corriente total en este modelo.
Cat6 o Cat6A no fijan por sí solos la sección, el material ni la resistencia continua. Intervienen hilos flexibles, terminaciones, temperatura, agrupamiento y desequilibrio entre conductores. Una cámara que se aproxima a una carga de potencia constante puede aumentar corriente cuando cae la tensión, agravando la caída; durante el arranque o la protección por subtensión su comportamiento será diferente. Si falla un cable largo y uno corto funciona, conviene cruzar la tensión cargada en el PD, el estado del PSE y el momento del reinicio antes de atribuirlo a una causa única.
También hay pérdidas dentro del PC. Con una carga interna de 65 W y eficiencia principal del 90 %, más 80 W de salida PoE con eficiencia del 88 %, la entrada estimada es 65/0,90 + 80/0,88 ≈ 163,1 W: unos 6,8 A a 24 V o 9,1 A a 18 V. Si esos 65 W ya se han medido en la entrada externa, no deben volver a dividirse por la eficiencia. Es importante indicar siempre el punto de medición; de lo contrario, el cálculo puede duplicar pérdidas o ignorar el límite de terminales, fusibles y mazos.
La carga continua, la reducción de potencia a alta temperatura y el arranque simultáneo se comprueban por separado. Un margen fijo de 1,3 o una reducción universal del 15 % no describen un pico de milisegundos ni una curva térmica real. Un arranque escalonado puede ayudar, siempre que también se ejecute después de un corte de alimentación. Las cámaras con iluminación o calefacción se miden con esas funciones activadas; un flash alimentado aparte puede seguir perturbando la misma barra de continua.
Calcular el ancho de banda desde un fotograma
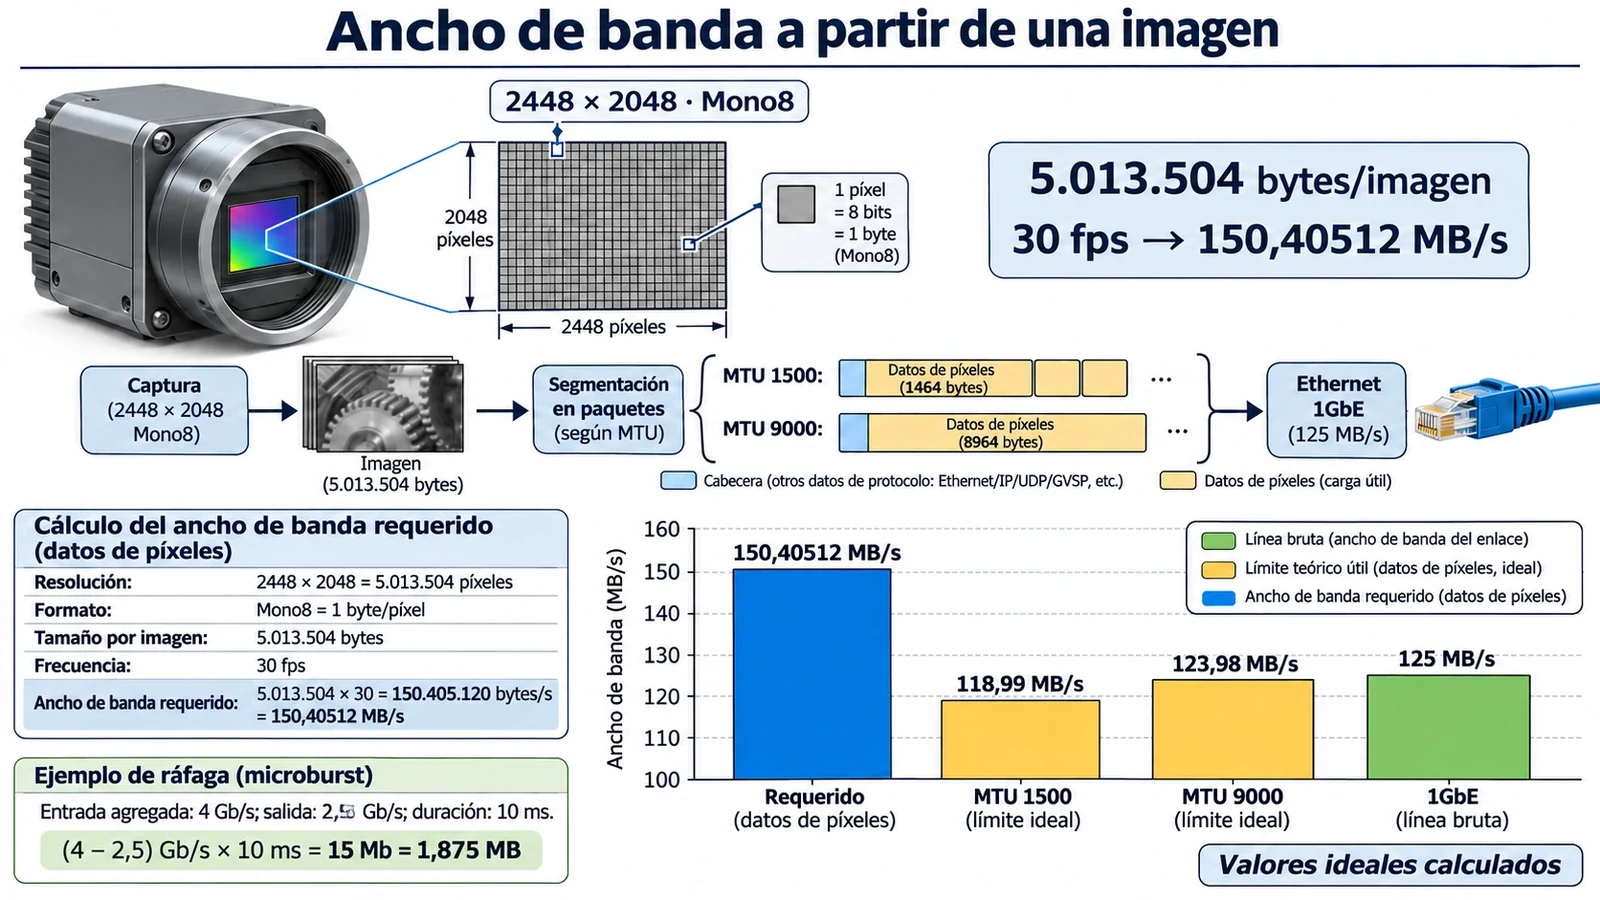
Una imagen de 2448 × 2048 en Mono8 contiene 5.013.504 bytes: 5,013504 MB decimales o aproximadamente 4,78125 MiB. A 30 fps produce 150,40512 MB/s, equivalentes a 1,20324096 Gb/s, antes del protocolo. Ya supera la capacidad física de 1GbE. Más memoria, un procesador más rápido o las tramas jumbo no corrigen un déficit sostenido de enlace. Las opciones son cambiar toda la ruta de transmisión o acordar una demanda menor mediante fps, ROI o formato que la cámara realmente soporte.
Doce bits de información no significan siempre 1,5 bytes transmitidos por píxel. Un formato empaquetado de 10 o 12 bits puede emplear 1,25 o 1,5 bytes; un contenedor de 16 bits utiliza 2 bytes. RGB8 requiere 3 bytes por píxel. La referencia final es PayloadSize, incluidos rellenos, datos Chunk u otros componentes. Las definiciones PFNC y SFNC se encuentran en la documentación GenICam de EMVA. Un flujo Bayer8 convertido a RGB y luego a tensores de coma flotante aumenta el tráfico de memoria; el fichero guardado puede tener otro tamaño. Red, procesamiento y disco necesitan presupuestos diferentes.
Los 125 MB/s de 1GbE son velocidad de línea. Para mostrar el efecto del encapsulado, supongamos IPv4 sin opciones ni VLAN y cabecera GVSP tradicional de 8 bytes. Con MTU 1500 quedan 1500 − 20 − 8 − 8 = 1464 bytes de píxeles. Contando Ethernet, FCS, preámbulo y tiempo de separación, el paquete ocupa 1538 bytes en el enlace: 125 × 1464/1538 ≈ 118,99 MB/s ideales. El mismo modelo con MTU 9000 da 125 × 8964/9038 ≈ 123,98 MB/s. No es una medición, y aún hay que considerar mensajes de inicio y fin de imagen, retransmisiones y otras variantes de cabecera.
A 100 MB/s, el modelo pasa de unos 68.300 paquetes/s a unos 11.200 al aumentar la carga útil de 1464 a 8964 bytes. Eso puede reducir trabajo por paquete, pero no convierte un enlace de 1 Gb/s en uno de 1,2 Gb/s. Las tramas jumbo exigen compatibilidad en cámara, conmutadores y adaptador. MTU 9000 y un ajuste Windows «Jumbo Packet 9014» pueden contar campos distintos. La guía de Intel explica este tipo de configuración; una puesta en marcha razonable establece primero una base funcional y aumenta el tamaño con verificación de extremo a extremo.
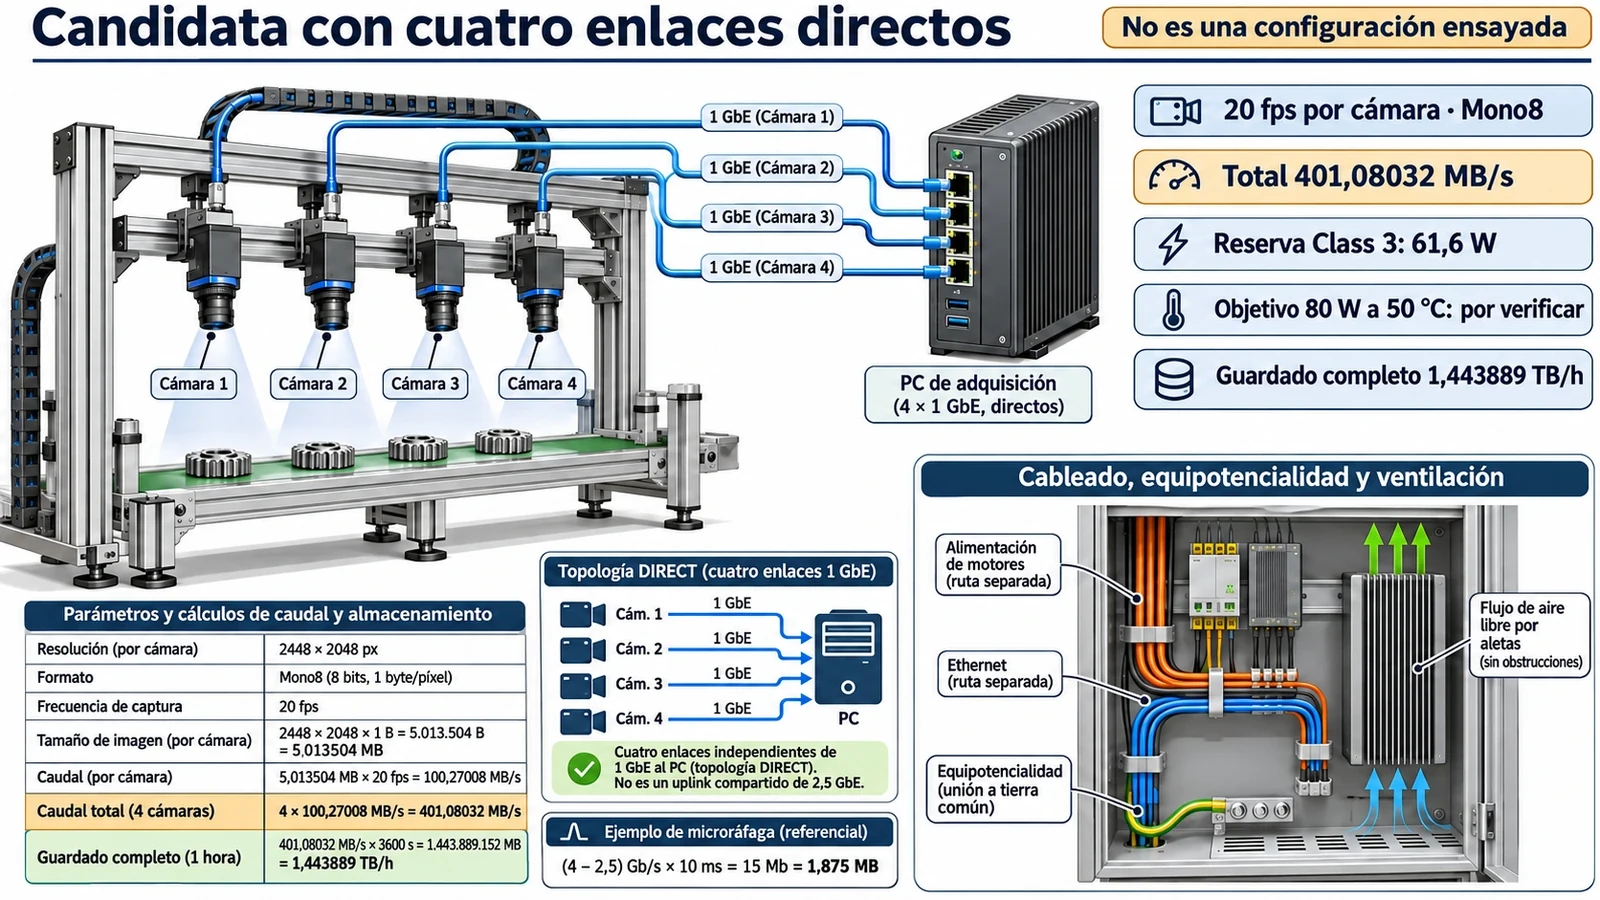
Cuatro cámaras del ejemplo a 15 fps ya suman unos 300,81 MB/s, o 2,406 Gb/s netos. Con cuatro enlaces directos se reparten externamente, mientras que un único enlace ascendente de 1GbE no sirve. Uno de 2,5GbE deja poco margen al añadir protocolo y recuperación. La agregación habitual distribuye flujos: no garantiza dividir un solo flujo UDP de cámara entre dos enlaces ni repartir varias cámaras de forma uniforme.
De los paquetes a la imagen utilizable
En GigE Vision tradicional, GVCP se ocupa del descubrimiento y control, mientras que GVSP transporta las imágenes. GenICam describe funciones y su acceso. Leer la exposición demuestra que responde el canal de control, no que la ruta de imágenes soporte todo el caudal. Un timeout de heartbeat tampoco demuestra un corte de alimentación: puede deberse a un hilo bloqueado o a un cambio de ruta. Las capacidades GVRSP/RDMA de GigE Vision 3.0 necesitan soporte en cámara, receptor y software; no aparecen por actualizar un equipo antiguo. A3 explica su ámbito.
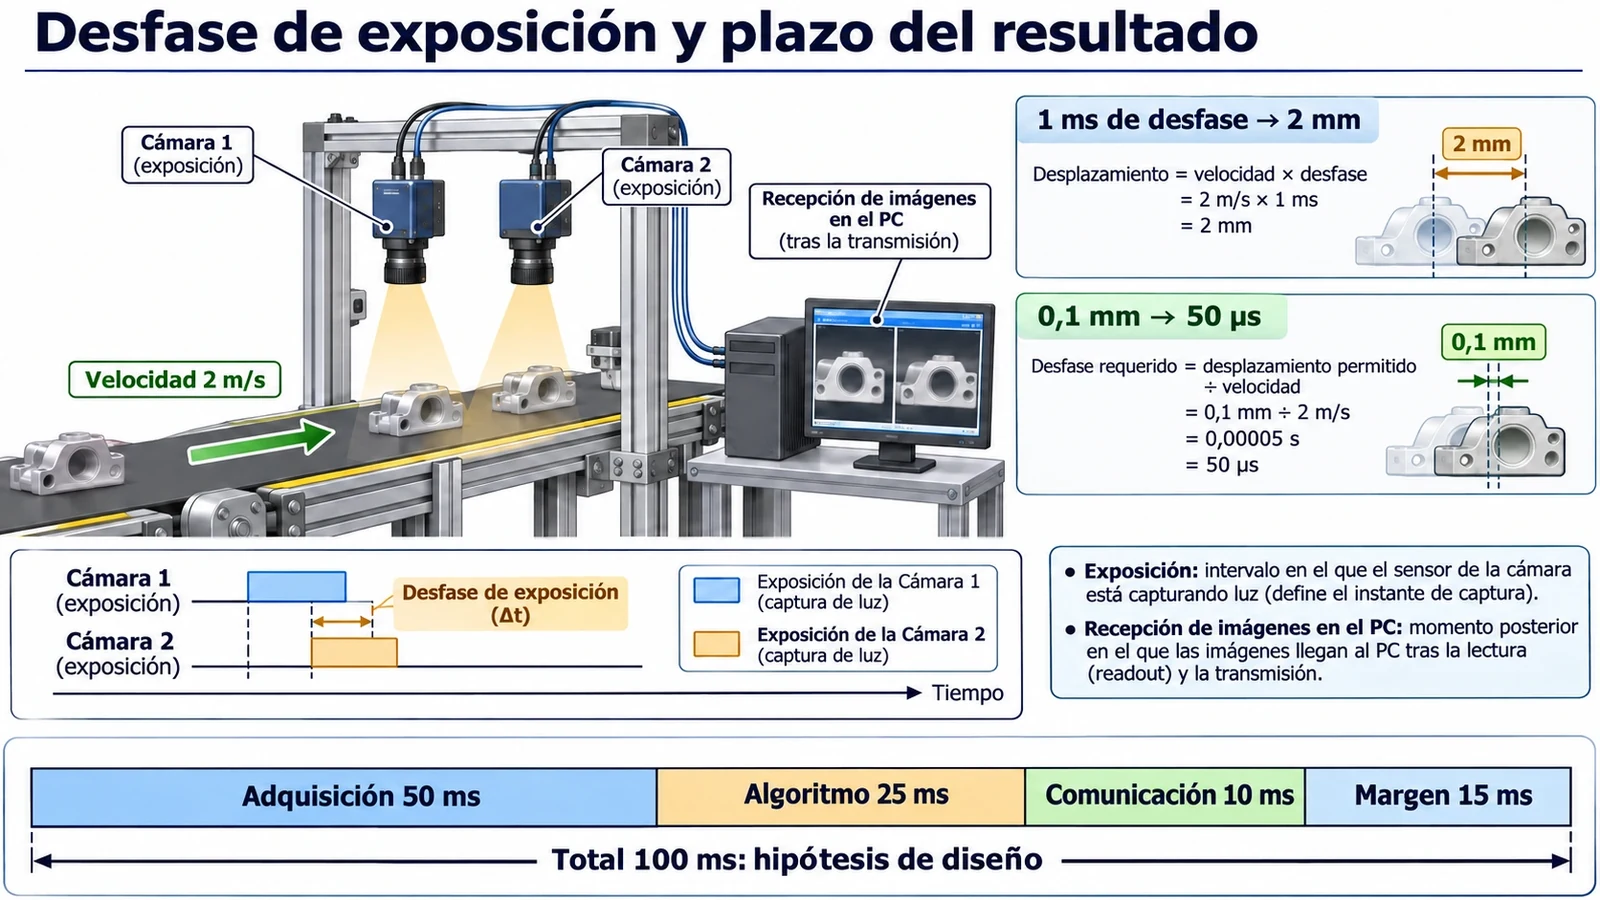
GVSP sobre UDP reconstruye imágenes a partir de identificadores y secuencias de paquetes. Puede haber pérdidas, duplicados, desorden y recuperación. Un reenvío solo ayuda si la cámara conserva los datos, recibe la solicitud y la respuesta llega antes de agotar el tiempo de retención y el plazo de inspección. Si el resultado debe salir en 80 ms, la imagen termina de recuperarse en 70 ms y el cálculo tarda 20 ms, la imagen es completa pero el resultado llega tarde. Ampliar los timeouts puede reducir imágenes incompletas y, a la vez, aumentar imágenes caducadas y ocupación de memoria. El modo de vista previa «solo el último fotograma» no debe aplicarse silenciosamente a una inspección de todas las piezas.
Las estadísticas pertenecen a capas distintas. CRC/FCS describe errores detectados en un punto de recepción; los descartes de NIC o controlador incluyen falta de recursos; Resend puede contar peticiones, paquetes o imágenes según el SDK; Incomplete Frame se refiere a la imagen final; Application Drop ocurre después de la recepción. Además debe contarse la imagen que una pieza necesitaba y que no estuvo disponible a tiempo, aunque un contador «Lost» del SDK no aumente. Así quedan visibles los disparos rechazados, los descartes deliberados y los emparejamientos erróneos.
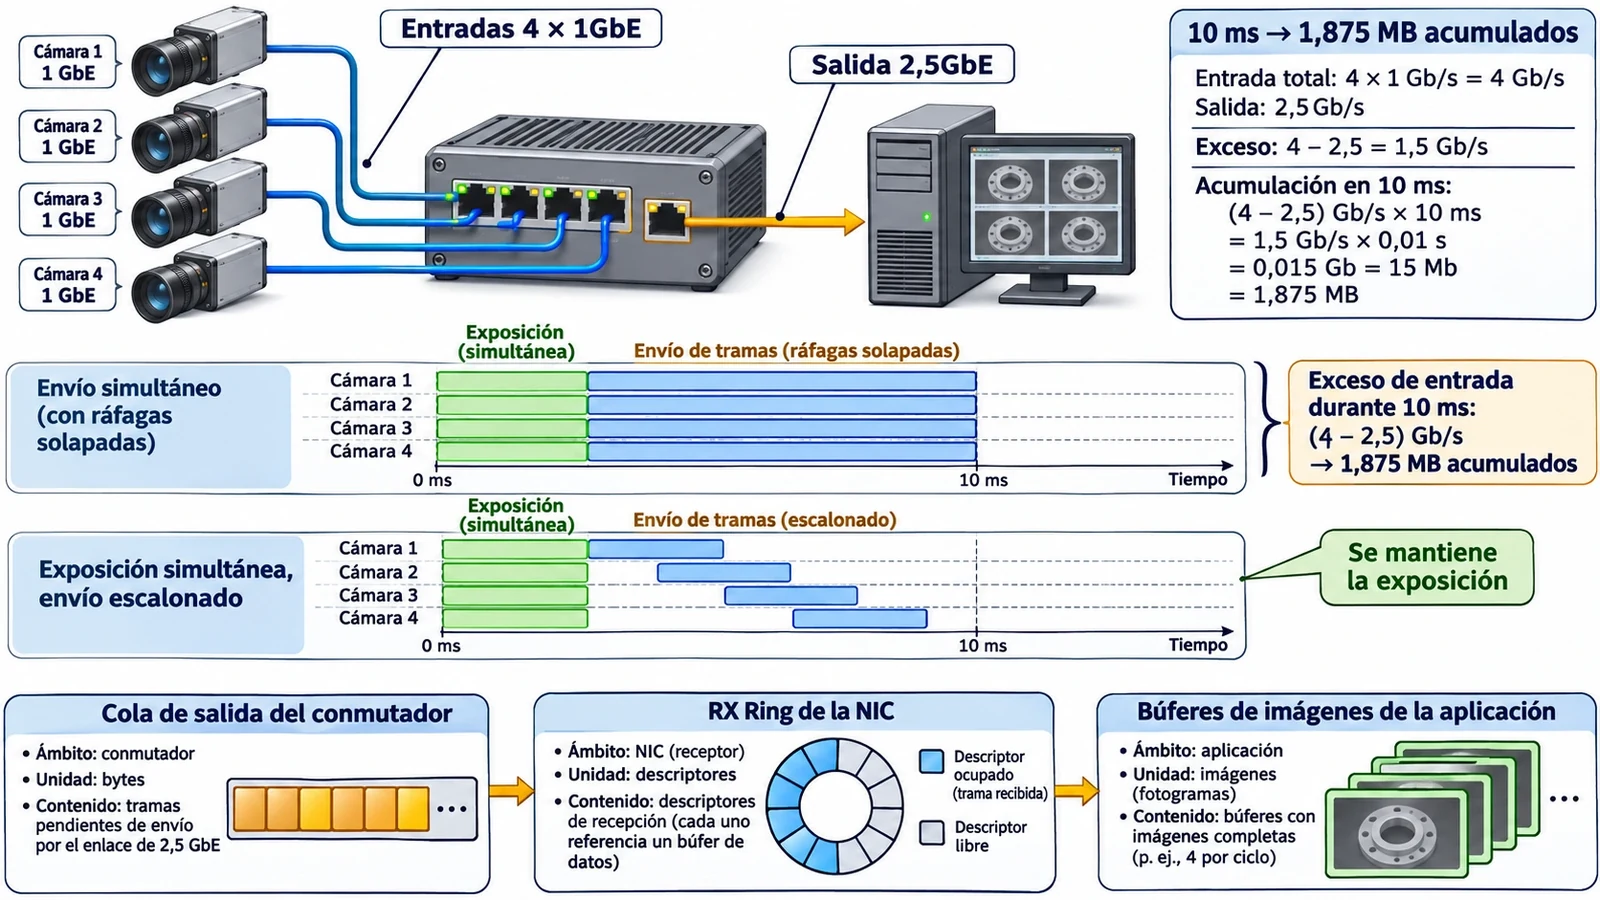
El tráfico medio no describe todos los problemas. En un ejemplo independiente, cuatro entradas 1GbE envían casi a velocidad de línea hacia una salida de 2,5GbE. Si la diferencia de 1,5 Gb/s dura 10 ms, se acumulan aproximadamente 1,875 MB. El búfer total del conmutador no siempre está disponible para esa única salida. En una conexión directa de cuatro cámaras no existe ese mismo cuello de botella externo, pero puede haberlo en PCIe, recepción o aplicación. VLAN, QoS y Pause no crean capacidad sostenida que falta en la salida.
GevSCPD separa paquetes y GevSCFTD retrasa el inicio de una transmisión. La documentación de Basler permite entender el mecanismo, sin trasladar valores o unidades automáticamente a otra cámara. Para 5,0135 MB se necesitan unos 560 paquetes de 8964 bytes útiles; añadir 10 μs entre ellos alarga aproximadamente 5,6 ms una transmisión que ya ronda 40,4 ms. A 20 fps, el periodo completo es de 50 ms. Reducir reenvíos a costa de no terminar antes de la imagen siguiente no es una mejora. Cuando la geometría exige exposición simultánea, puede escalonarse la transmisión si el equipo lo permite; no debe alterarse la exposición para maquillar la red.
Lo que comparten los cuatro conectores dentro del PC
Detrás de cuatro RJ45 puede haber controladores independientes, un controlador multipuerto o un conmutador integrado. Interesa el diagrama desde cada puerto hasta PCIe y CPU o chipset, junto con las rutas compartidas con GPU y NVMe. Por carril y sentido, después de codificación y antes del gasto de transacciones, PCIe ofrece aproximadamente 250 MB/s en Gen1, 500 en Gen2, 984,6 en Gen3 y 1969,2 en Gen4. Cuatro flujos cercanos al máximo, unos 480 MB/s útiles, dejan escaso margen si comparten Gen2 x1. Un cálculo de 300,81 MB/s indica posibilidad, no prueba: deben comprobarse velocidad negociada, ancho real y puentes ascendentes. Una ranura mecánica x4 puede estar cableada x1.
El RX Ring utiliza descriptores para indicar memoria de recepción; no es el conjunto de fotogramas del SDK. Suponiendo un descriptor por paquete, 512 libres a 68.300 paquetes/s representan solo unos 7,5 ms sin servicio. Aumentar profundidad absorbe algunas pausas, pero cambia memoria y espera. Ningún búfer finito resuelve que el receptor procese menos de lo que llega de forma permanente.
La carga global de CPU puede ocultar un núcleo saturado por interrupciones, SoftIRQ de Linux, DPC de Windows, recepción o decodificación. RSS distribuye flujos entre colas, pero un flujo GVSP suele conservarse en una cola para mantener orden: habilitar ocho colas no divide automáticamente una cámara entre ocho núcleos. La documentación del kernel Linux detalla estos mecanismos. En NUMA o plataformas de núcleos heterogéneos también importa dónde están hilos y memoria. Afinidad e interrupciones agrupadas se valoran comparando latencia y recepción, no solo una cifra menor de CPU.
Dentro de la aplicación, cálculo, interfaz y escritura síncrona no deberían bloquear de manera prolongada el callback de adquisición. Una cola acotada facilita separar funciones, pero exige respetar la propiedad de la memoria. Si el SDK reutiliza un bloque al devolver un resultado y el hilo de guardado conserva solo su puntero, puede escribir una imagen posterior sobre el fichero equivocado. Retener el objeto, contar referencias o copiar a memoria propia depende del SDK. «Cero copia» reduce movimiento de datos, aunque puede mantener ocupado más tiempo el búfer de captura. La política de desbordamiento debe ser explícita; frenar la línea también tiene una demora durante la cual seguirán llegando piezas.
Guardar imágenes: cuánto se acumula cuando el SSD se frena
Cuatro cámaras Mono8 de 2448 × 2048 a 20 fps generan 401,08032 MB/s. Guardarlo todo equivale a unos 1,443889 TB/h o 34,65334 TB/día. El almacenamiento de defectos, el muestreo de piezas buenas, la grabación de mantenimiento y una racha de defectos son condiciones diferentes. Una política del 1 % puede volver repentinamente al caudal completo. La compresión depende del contenido y añade cálculo; un fondo uniforme no representa todas las imágenes de producción.
El pico anunciado de un SSD no describe su comportamiento después de agotar caché, con poco espacio, borrado circular, muchos ficheros y temperatura elevada. La prueba utiliza el formato y la política de persistencia finales, y registra caudal estable, distribución de latencias, pausa máxima y nivel de cola. Una media de 600 MB/s podría incluir segundos sin completar escrituras, suficientes para agotar la adquisición.
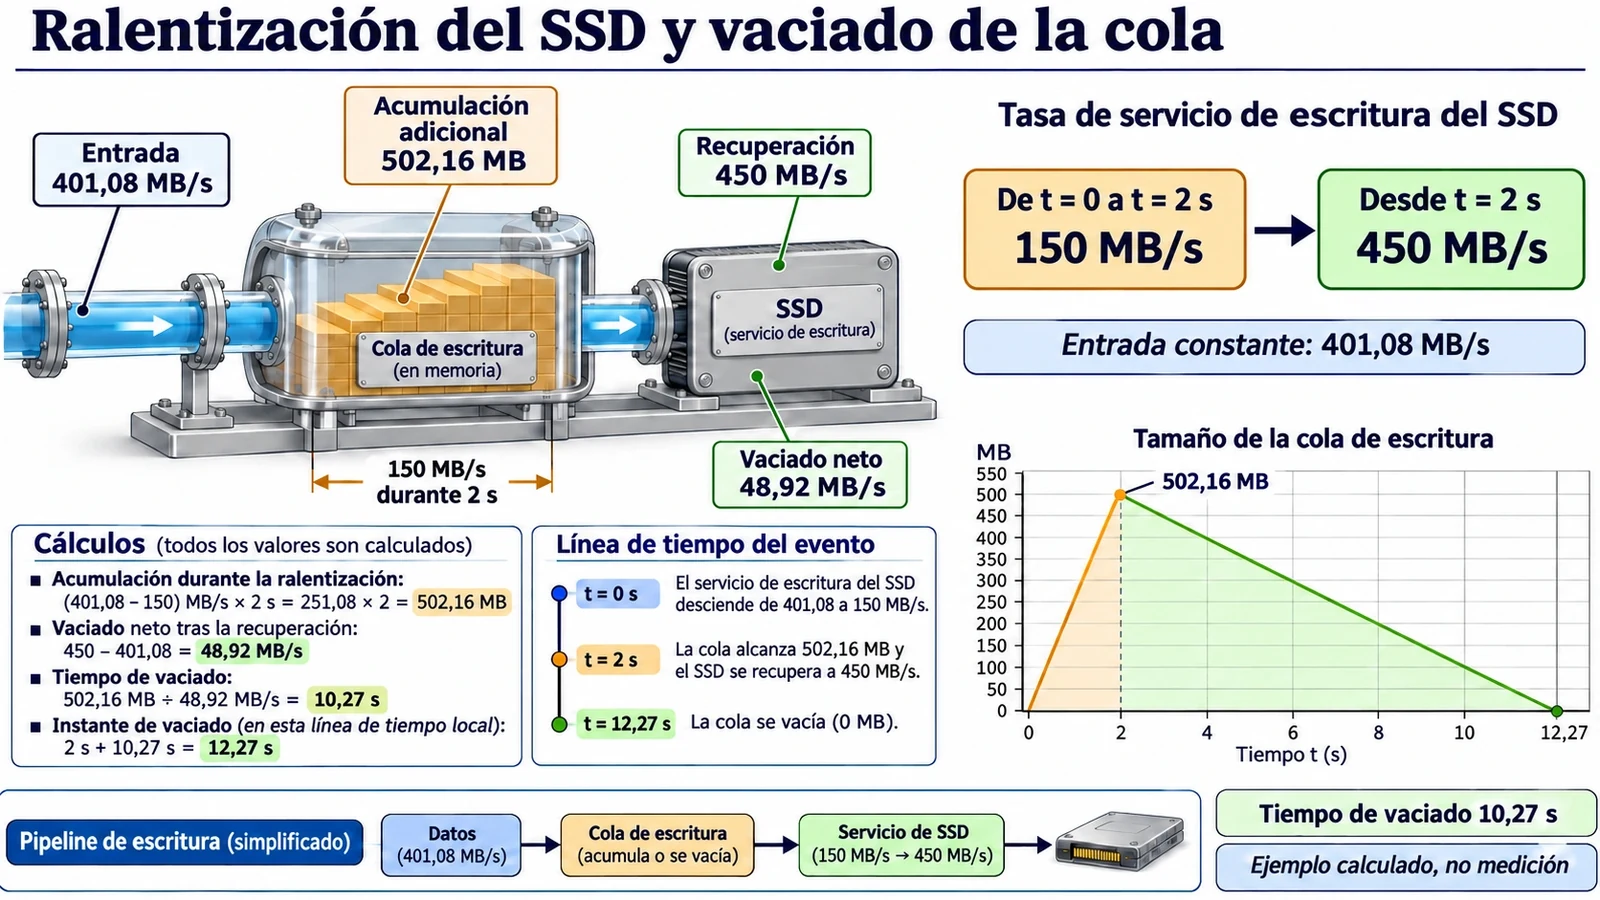
Con entrada de 401,08 MB/s, una parada de 0,5 s añade unos 200,54 MB; bajar a 150 MB/s durante 2 s añade 502,16 MB. Al recuperarse a 450 MB/s solo quedan 48,92 MB/s para vaciar lo acumulado, por lo que ese exceso tarda unos 10,27 s en desaparecer. Un gigabyte libre en la cola no es un gigabyte íntegro para esta pausa: ya existen imágenes en espera, copias, índices y memoria reservada al SDK. Hay que demostrar que el sistema puede alojar la acumulación y vaciarla antes de la siguiente perturbación, sin perder el plazo de las imágenes que todavía importan para el proceso.
TBW y DWPD se interpretan en sus condiciones nominales, como explica Micron. Un SSD de 600 TBW alcanzaría esa cantidad en unos 17,3 días escribiendo 34,65 TB/día, pero eso no significa que falle necesariamente el día 18. Una unidad de 3,84 TB y 1 DWPD corresponde aproximadamente a 3,84 TB diarios bajo su definición, muy por debajo de este flujo completo. Si el fabricante define TBW como escrituras del host, multiplicarlo además por una amplificación interna NAND puede mezclar puntos de medida.
RAID y persistencia resuelven otros riesgos. RAID 0 pierde el conjunto si falla un miembro; en RAID 1 cada SSD sigue recibiendo toda la escritura. Ninguno sustituye el respaldo independiente o la protección frente a borrado. La protección contra pérdida de alimentación del SSD no conserva lo que la aplicación aún no ha enviado. Retorno de API, caché del sistema, confirmación de persistencia y fichero recuperable al reiniciar son estados distintos. Segmentación, sumas de comprobación, índice y marca de final permiten identificar colas incompletas. O_DIRECT sirve para estudiar una ruta sin caché de páginas, no es una configuración obligatoria ni garantiza por sí mismo persistencia.
Sincronizar la exposición y cumplir el plazo no es lo mismo
Una pieza a 2 m/s avanza 2 mm en 1 ms. Si solo se admiten 0,1 mm de error por desincronización, la diferencia de exposición dispone de 50 μs. No es el tiempo máximo para recibir las imágenes, ni incluye calibración óptica, vibración o desenfoque. En un sensor rolling shutter, distintas filas representan momentos distintos aunque dos cámaras reciban el mismo disparo. Un único timestamp no convierte todos los píxeles en simultáneos.
El disparo software depende de planificación del host, red y respuesta de cámara; su idoneidad sale del jitter medido y la tolerancia del proceso. No corresponde asignarle universalmente 10–100 ms ni prohibirlo en toda pieza móvil. El disparo hardware también requiere niveles, polaridad, anchura mínima, retardos de aislamiento y carga del distribuidor. Con encoder hay que contar pulsos, exposiciones aceptadas y fotogramas, incluyendo aceleraciones, inversión y cámara ocupada; un pulso externo no equivale automáticamente a una exposición válida.
PTP aporta una referencia temporal común. El estado Locked no demuestra por sí solo exposiciones simultáneas. Las cámaras compatibles pueden ejecutar acciones programadas mediante Scheduled Action Commands, con comprobación de reloj, llegada del comando y preparación del sensor. La explicación de Basler es una implementación de referencia. La precisión depende de timestamping, asimetría y equipos; no puede prometerse menos de 1 μs para cualquier configuración. Después de un cambio de reloj maestro, caída o reinicio, el estado de producción debe reflejar si la sincronización vuelve a cumplir el requisito.
Para agrupar vistas se combinan identidad de disparo, fotograma y tiempo referido al mismo dominio. El orden de llegada de los callbacks no basta. Si falta una vista, no se completa con la imagen de la pieza siguiente. Una prueba que omite deliberadamente una cámara permite comprobar que se identifica la pieza afectada. La orden de rechazo se vincula a esa identidad o a la posición del encoder; un pulso NG aislado puede perder su significado después de una parada o de una cola acumulada.
Ejemplo integrado de cuatro cámaras
La petición inicial es cuatro cámaras 2448 × 2048, Mono8 y 30 fps, con cables PoE de 40 m. Un enlace 1GbE por cámara no satisface esa demanda. Para continuar el ejemplo, supongamos que producción valida 20 fps, exposición simultánea, resultado en 100 ms y ambiente de 50 °C alrededor del PC. Es un cambio documentado del requisito, no una optimización aplicada sin consentimiento del responsable del proceso.
| Magnitud | Valor del ejemplo |
|---|---|
| Datos de un fotograma | 5.013.504 bytes |
| Una cámara a 20 fps | 100,27008 MB/s |
| Cuatro cámaras | 401,08032 MB/s, 80 imágenes/s |
| Originales durante una hora | 1,443889 TB |
| Originales durante un día | 34,653340 TB |
| Entrada PD máxima supuesta | 12 W por cámara |
| Asignación total Class 3 | 61,6 W |
Con el modelo MTU 9000, cada enlace ocupa aproximadamente 101,10 MB/s de línea, unos 808,8 Mb/s. Esa utilización no es un criterio universal del 80 %: faltan cabeceras de imagen, reenvíos y variación real. Cuatro conexiones directas evitan un enlace ascendente externo compartido, aunque no los recursos internos. Si se utiliza conmutador, 10GbE puede ser una candidata con margen; también se revisan colas, trama admitida, temperatura, PSE y PCIe de la NIC. Trasladar la alimentación al conmutador cambia el límite entre equipos: no se vuelven a sumar los mismos 80 W como salida PoE del PC.
Con PSE aproximadamente a 54 V, entrada PD de 12 W, corriente estimada de 0,23 A y bucle de 3,36 Ω, la pérdida es unos 0,18 W por cámara. La salida continua conjunta ronda 48,7 W, mientras que la reserva de clase sigue en 61,6 W. Para este caso se puede seleccionar una candidata de al menos 80 W de presupuesto total a 50 °C y dentro del rango de entrada requerido; después se ensayan arranque, puerto y cable reales. No es una regla general para cuatro cámaras. Si el resto del PC consume internamente 70 W y se usan eficiencias de 90 % y 88 %, el dimensionado a salida PSE de 80 W da unos 168,7 W externos, antes de periféricos y condiciones transitorias no incluidas.
Treinta y dos fotogramas de SDK por cámara requieren unos 5.013.504 × 32 × 4 = 641,73 MB solo de píxeles. El sistema recibe un grupo de cuatro vistas cada 50 ms. Un algoritmo de 20 ms por imagen ejecutado en serie necesita 80 ms por grupo y no sostiene la entrada. Paralelismo, lotes o optimización se valoran con el modelo real. Si guardar imágenes es asíncrono al veredicto, puede aislarse su latencia; si el proceso exige persistencia antes de confirmar el resultado, el disco pertenece a la ruta de 100 ms y hay que volver a demostrarla.
Una hora de originales, 1,443889 TB, exige espacio utilizable después de sistema, formato y reserva. Una unidad nominal de 2 TB es una candidata, no una aprobación automática. El objetivo de 600 MB/s sostenidos puede servir para este ensayo, junto con sus pausas y capacidad de vaciado; no es una prestación que el artículo atribuya a un producto. Operar 16 horas y guardar el 1,5 % sin contar compresión produce unos 0,3465 TB/día. Una hora adicional de depuración completa añade 1,4439 TB. Conviene limitar ese modo, mostrarlo de forma visible y terminarlo automáticamente para que no se mantenga olvidado.
En la instalación, cable de mayor categoría no implica aptitud para cadena portacables, y pantalla no sustituye conductor de protección o unión equipotencial. Las terminaciones se resuelven conforme al equipo y al entorno, sin convertir «un solo extremo» o «ambos extremos» en consignas universales. Alejar temporalmente el cable de potencia es un contraste útil, no un ensayo EMC completo. La fibra puede aislar datos, pero no transporta PoE y deja una alimentación local por resolver.
Los 80 W que salen por PoE tampoco se convierten íntegramente en calor dentro del PC. Con eficiencia del 88 %, la pérdida del convertidor es unos 10,91 W. Si las cámaras comparten un armario cerrado, su calor vuelve al balance del armario, no al mismo punto de medida. Un SSD caliente puede alargar escrituras, elevar la cola y terminar agotando la adquisición, aunque el síntoma final parezca de red. Temperatura local, estado de CPU/SSD, causa de limitación de frecuencia y colas deben registrarse juntas; una termografía de carcasa no sustituye la temperatura de los componentes.
Puesta en marcha y recuperación reproducibles
Una secuencia útil empieza con una cámara y paquetes estándar; añade después parámetros finales, varias cámaras, disparo simultáneo, algoritmo, guardado y carga térmica. Cambiar una clase de ajuste cada vez conserva la relación entre causa y efecto. Se fija la correspondencia serie de cámara–puerto físico–interfaz del sistema–IP–vista. Varias NIC independientes en la misma subred o una VPN y Wi-Fi con rutas preferentes pueden provocar fallos antes de que intervenga el ancho de banda. Los parámetros guardados se releen tras arrancar: ROI, exposición, trigger, paquete, retardos y sincronización.
El PLC recibe Ready cuando las cámaras están identificadas, configuradas, sincronizadas y con búferes preparados, no simplemente cuando se abre una conexión. Al perder una cámara se termina la sesión anterior, se marcan grupos y piezas afectados, se liberan datos antiguos y se repite identificación, lectura de configuración y preparación antes de aceptar nuevas piezas. Reiniciar remotamente un puerto PoE requiere límite de intentos e intervalos; repetir indefinidamente puede ocultar una avería y afectar a puertos que comparten fuente.
El registro periódico resume disparos, imágenes completas/incompletas, reenvíos, descartes, colas, tiempos y temperatura. Alrededor de una anomalía conserva un intervalo corto con identidad de pieza y versión de configuración. Reloj monótono para duraciones y hora civil para mantenimiento tienen funciones distintas; los timestamps de cámara necesitan su correspondencia. Registrar cada paquete añade carga, y la propia captura puede perder datos. En Linux, por ejemplo, estas lecturas dan puntos de observación, sustituyendo la interfaz y consultando el significado real de cada campo:
ip -br address
ip route
ip -s link show dev enp3s0
ethtool -i enp3s0
ethtool -S enp3s0
ethtool -g enp3s0
ethtool -l enp3s0
lspci -tv
mpstat -P ALL 1
iostat -x 1
Los contadores se comparan por incrementos y se anotan reinicios o puestas a cero. Un campo no disponible no vale cero. Los nombres de ethtool -S dependen del controlador; el %util de NVMe o una captura de CPU global no demuestran saturación por sí solos. Windows requiere datos equivalentes de adaptador, driver, Jumbo Packet, Receive Buffers, RSS, DPC y latencia de disco. Un filtro específico del SDK puede explicar diferencias entre estadísticas generales y del receptor.
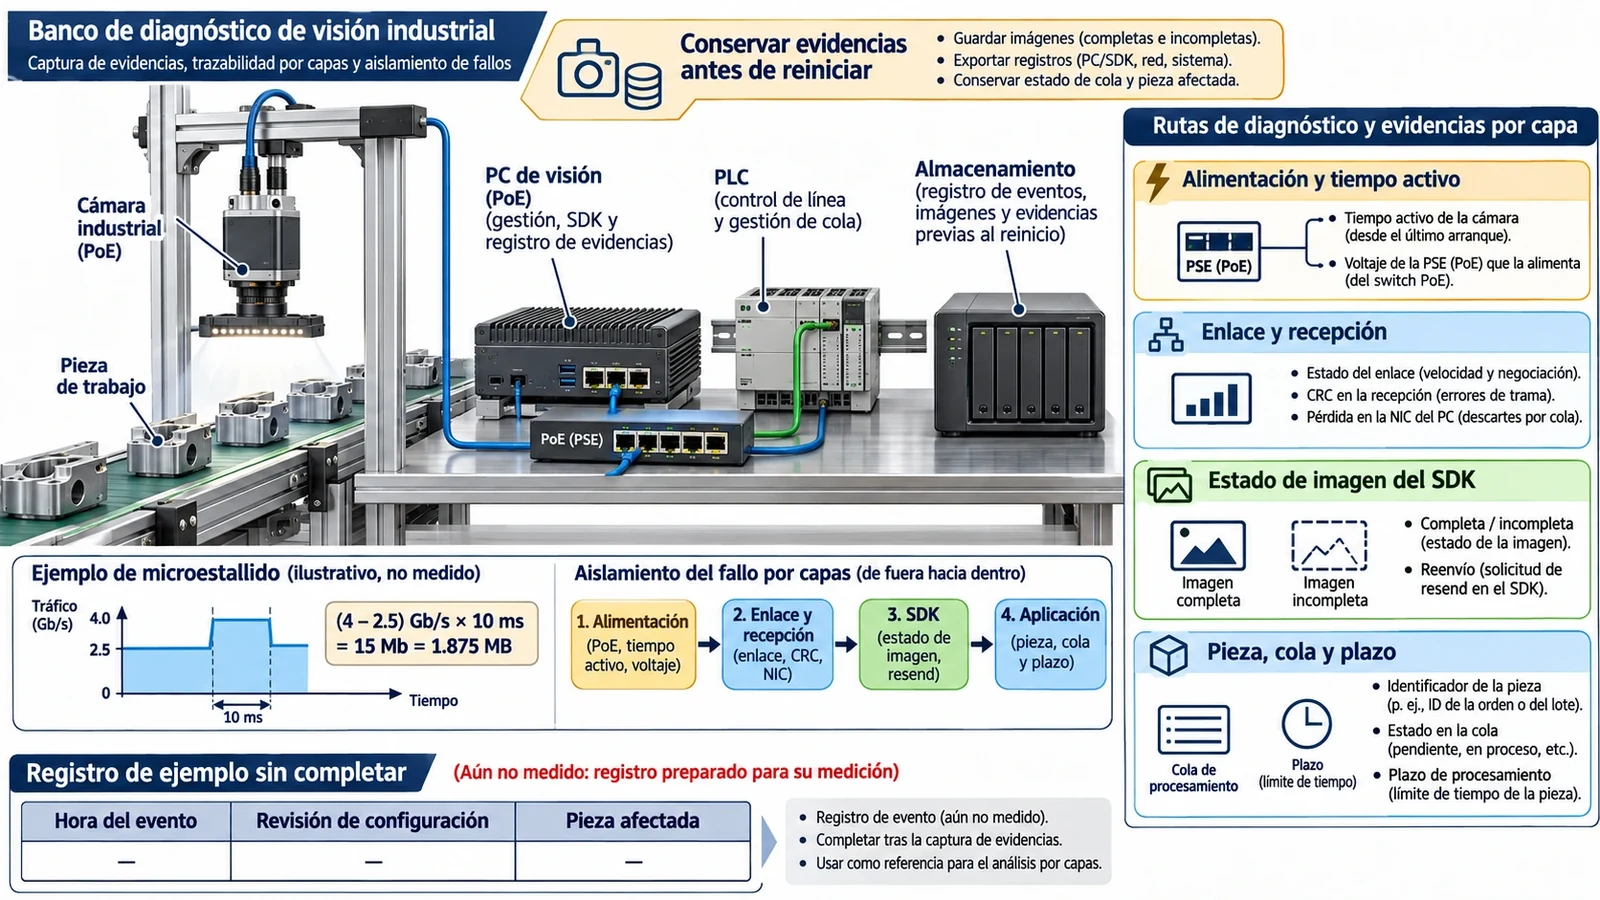
Si aumentan reenvíos pero no CRC, se revisan salida del conmutador, recursos de recepción, desorden, planificación y definición del contador. CRC normal solo describe ese punto de medida. Si el fallo aparece al guardar, se compara con y sin escritura manteniendo adquisición y algoritmo. Si coincide con motores, se ordenan temporalmente tensión, PSE, reinicios y enlace. «Se recuperó al reiniciar el puerto» es un hecho de recuperación; atribuirlo a falta de potencia exige otra evidencia.
La duración de la prueba pertenece al proyecto. Setenta y dos horas no es un umbral universal: cuatro cámaras a 20 fps generan 20.736.000 imágenes y unos 103,96 TB de originales. Puede separarse una prueba larga con política de producción de otra de escritura completa con capacidad conocida. Se registran percentiles, máximo medido y, directamente, las veces que se supera el plazo acordado. P99 no sustituye un requisito de cero resultados tardíos.
La comprobación final concilia piezas, imágenes, resultados y excepciones. Una pieza recibe todas sus vistas y un resultado a tiempo, o queda identificada para detener, separar o reinspeccionar según el proceso; no desaparece silenciosamente de la estadística. Desconexión de una cámara, escritura lenta, disco lleno y reinicio en mitad de un grupo permiten verificar esa respuesta, incluida la recuperación de ficheros e índices. Con revisiones de hardware, firmware, controlador, SDK, aplicación y parámetros archivadas, otro técnico puede repetir tanto el arranque como la recuperación. Esa reproducibilidad es lo que hace mantenible el sistema cuando cambian la temperatura, las cargas o los componentes.
Referencias técnicas
Las fuentes enlazadas explican conceptos y mecanismos; no certifican capacidades ni resultados de Geshem. Para un proyecto se conserva la revisión utilizada junto con la documentación de sus modelos concretos.
- TI: características de alimentación PoE
- EMVA: GenICam
- Basler: parámetros de red
- Basler: Scheduled Action Commands
- Linux kernel: escalado de red
Para preparar la configuración de visión artificial PoE, pueden compararse los equipos de PC industriales embebidos sin ventilador y las interfaces y condiciones de alimentación del PC-GS6277A. Este modelo declara un máximo total de 40 W PoE compartido por cuatro puertos. El objetivo de 80 W utilizado en el ejemplo de cuatro cámaras requiere otra configuración que lo admita, seguida de la validación del procesamiento, el almacenamiento y las condiciones térmicas.